笔记
大模型 1
embedding
科学家知道想要让机器理解自然语言,先用向量表示词了。
把单词映射成低维 稠密的向量。这个低维 稠密都是和前人的独热编码相比。
此外,embedding 不止局限于词,图,推荐系统(用户和商品的向量接近说明有喜好关系)、蛋白质的氨基酸序列 也可以做 embedding。
不能做到什么
做到了计算机可以处理离散的符号。但是计算机还没有理解词与词之间的关系,
word2vec
历史性的进步。
发现向量可以包含语义 和 语法结构,并且向量运算可以捕捉词之间的关系。
例子:经过训练之后的向量,国王的向量-男人+女人 得到的向量,竟然和王后的向量很接近!
词向量在空间中的分布是有规律的:意思相近的词在空间中聚集在一起。(这个空间是 128 维、256 维度等等画不出来,类比二维想象一下)。
训练方式
word2vec 是 embedding(词嵌入)的一种实现方式。原论文提出的训练方式有 : 用上下文猜中心词,用中心词预测上下文词;
embedding 思想,向量的数字是训练得到的,Google 提出的word2vec 是前期一种高效的训练方式。训练实现 是 通过浅层神经网络 。
RNN
让模型从理解单词进步到读懂语句。
思想
维护一个隐藏状态(向量)。这个向量由 当前输入 和 上一步的隐藏状态 一块计算得到。
Transformer
点积相似度
点积相似度的计算公式。两个向量点积的结果越大,说明夹角越小,两个向量的相似度越高。
- 为啥点积的结果能衡量相似度? 点积的几何意义是两个向量的模长乘以夹角的余弦值,点积结果越到说明他们的模长和夹角越接近。 嵌入向量Embedding负责把离散的符号(词、物品等)映射到连续向量空间中的点,这个空间被设计成,现实中语义相近的实体,嵌入向量在空间中也接近。
- 还有余弦相似度。点积的结果处理两个向量的模长。
嵌入层
本质是一个矩阵,大小是 词汇量总数X嵌入向量的维度。矩阵每一行对应一个词向量,行号就是这个词在词汇表的编号。
深度学习模型中,词向量一般不用外部预训练好的,而是让模型自己学习。
工作原理:输入一个词的索引,例如5,嵌入层取出矩阵地5行的向量作为输出,在训练过程中,这些向量会通过反向传播更新;
知道什么是独热编码one-hot;性质有啥;
层归一化Layer Norm
-
什么作用:深度学习模型Transformer和RNN常用,稳定训练加速收敛。
-
公式:计算这个向量所有维度的均值和方差,然后每个维度归一化(分母是根号下方差加上一个微小的整数),再进行缩放和平移。 同一样本的不同特征维度计算均值和方差。(归一化的均值和方差都来自自己) ;Batch Norm是同一批次的不同样本的同一纬度,计算均值和方差。
-
为什么不用batch Norm? (CNN常用 group norm),1Batch Norm在处理变长序列时,填充的Token会污染真实值。2从BN的计算公式看,batch的size大,归一化才更有效;而深度学习语言模型在训练推理时,一个batch是比较小的,甚至是1。
-
每一个batch里面的序列长度不一样。 一个batch有三个句子,但是三个句子的长度不一样,
-
(填充的一个padding是一个零向量,不是向量的某个位置);具体计算是:不同句子的同一个索引位置的向量,做一个归一化。
那么对同一纬度的所有位置,有的地方2个值,有的地方只有3个值,把真实Token 和 padding Token混在一起。 (NLP任务会填充padding。)
-
-
层归一化的两个可学习参数作用?有能力恢复恒等映射。设置两个值,让归一化操作之后的值恢复到归一化之前。
-
nn.LayerNorm(512)在哪个维度归一化?输入(batch, seq_len, 512)输出形状?- 一般来说会对输入张量的最后一个维度进行归一化。这里的512指明了需要归一化的特征维度的大小。 Batch 是句子的个数,seq_len是句子长度(长度为3,有三个词向量,512是Token的维度) 想象一下这个张量什么样?batch个二维数组。
-
问题8:在 Transformer 中,层归一化通常放在哪里?是“Post-LN”还是“Pre-LN”?二者有何区别?
- 原论文中,先做注意力层/FFN ,然后残差,最后归一化;这是Post-LN; Pre-LN是先做层归一化,再进入注意力层/FFN,最后残差。 有什么区别?
- 关键区别:梯度流动分析(数学原理未分析)。Post-LN 的梯度早期会消失/爆炸,需要学习率预热。Pre-LN梯度可以从深层无损传到浅层。更稳。
上下文语义
- 传统方法(静态词向量Word2Vec)为每个词分配一个固定的向量,无论出现在哪里,这个词的表示都不变。 Transformer中允许模型根据句子中其他词来调整当前词的表示。
- “Transformer中允许模型根据句子中其他词来调整当前词的表示“ 就是通过自注意力机制实现的。初始是静态的,然后不断变化训练。刚开始“苹果”被赋予一个向量(初始是静态的),然后经过点积、加权求和,他的内容都在不断变化。
一个简单的线性层
- 包含哪些:权重和偏置、前向传播(要干嘛)、反向传播(要干嘛)、优化器
- pytorch的 nn.Linear; 注意一下:输入参数(in_features, out_features);所以输入的向量X需要乘以的矩阵维度是:in x out ; 但是创建线性层时自动生成的权重矩阵是:out x in。 最值得注意的一点: 送入线性层的张量不管是多少维度,他只作用于最后一个维度,保持其他维度不变。
Transformer的位置编码
position是指这个向量在句子中的位置;维度1、维度2等等是指向量的第2个位置、第三个位置;
-
为什么正余弦编码要这么设计?从一个合格的位置编码的角度考虑。两个位置之间的向量距离能反应原始序列中的距离。
- 关键1:相对位置可以线性表示。 模型就能够利用线性变换学习相对位置的关系。 具体:任意一个position加k的位置编码都可以通过position的位置编码 进行一个固定的线性变换得到。
- 可以表示多尺度的位置信息。对于一个向量,根据公式可以看出,它的低维度,频率高,变化大,能区分精细位置;高纬度部分,频率低,周期大,用来衡量全局位置。
- 为什么位置编码直接相加就有效果了?
- 正弦余弦位置编码的公式
-
可学习位置编码
- 计算方法:预设一个句子最大长度Lmax, 可学习位置编码实际就是一个矩阵,大小为Lmax X dmodel (L max是句子的最大长度)。 一个句子实际就是一个二维矩阵,使用的时候,每一个句子都直接逐元素相加这个位置编码矩阵。
- 特点:这个矩阵会在训练过程中反向传播更新。
- 区别:不能外推。测试时如果遇到长度大于Lmax的句子,无法处理。 但是固定位置编码,可以外推到任意长度。
- BERT GPT 通常使用可学习位置编码。
- 相对位置编码。
-
为什么正余弦位置编码选择与原始嵌入向量相加,而不是维度拼接?
- 拼接的坏处:输入向量维度翻倍,后续权重矩阵全部翻倍,计算量和内存都爆炸增加;
- 相加的话,本质上可以写成线性变化,而注意力机制的核心就是线性变换和点击,相加后的向量,每一个位置融合了语义信息和位置信息,模型是可以学到如何利用这种混合表示。简单来说就是相加的效果足够使用,而且简单。
QKV矩阵
关键思想
-
一个词,先经过嵌入层,变成向量。
-
该输入向量然后乘以三个矩阵:Wq Wk Wv 得到这个矩阵的 QKV 向量。Q 表示这个向量想要什么信息;K(key 键) 表示这个向量有什么信息可以被关注;V 表示能提供给别人什么信息;Q、K、V 都由同一个输入 X 经过三个不同的线性变换得到
-
注意力公式:
记住三点:1 QK 计算相似度;2 softmax 计算注意力权重;3 使用权重对 V 加权求和;
问题
为什么点积之后要除以根号下向量的维度,而不是直接除以向量的维度。 为了让点积的方差为1,不让过大的值进入sofa Max。如果不缩放,点积的数值大小会随着d_k的增大而增大。 可以从数学角度证明,点积之后的方差是向量的维度,所以除以标准差,让方差等于1。
-
过大的值进入soft Max 会导致梯度很小。
-
为什么要除以根号下向量的维度?能不能带不带根号?
-
为什么 σ₀ 要对 z₀ 求导 :在实际反向传播中,我们需要知道每一个输出 σ_i 对每一个输入 z_k 的偏导,形成一个雅可比矩阵。
-
思考:权重矩阵是整个模型共享的。每一个句子,都用这个。但是因为输入X不同,产生的QKV也不同。 比如模型有8个头,每个头有自己的一组权重矩阵。
- 关于注意力矩阵:一个句子(二维矩阵,每一行是一个词向量)X;X乘以权重矩阵,得到Q,Q的尺寸是多少?(seq_len, d_model/num_heads)。 Q点积K得到的注意力矩阵: 第一行第一个元素,代表第一个词向量的Q和第一个词向量的K做点积得到的注意力分数,整个第一行是第一个词向量对这个句子所有的词向量的注意力得分。所以计算SoftMax时候,是对注意力矩阵的每一行进行的。
-
权重矩阵W_Q, W_K, W_V参数的更新方式?是否一致?
更新方式完全一样,都是反向传播计算梯度,然后梯度下降算法更新参数。但是因为他们在损失函数的位置不同,所以每一次的梯度也不同,学习到的内容都不同。
前馈神经网络FFN
-
为什么需要? 自注意力的点积、加权求和,都是线性变换。前馈层为了给模型增加更强的拟合能力。引入非线性变换。
-
组成:两层全连接层,中间有一个ReLU激活函数。 非线性是ReLU激活函数提供的,两个全连接层主要提供了很多可学习的参数,增加模型拟合能力。
-
具体操作:对每个Token单独计算,先把向量维度扩大4倍,经过激活函数,再缩小到4倍。 为什么中间维度要放大到4倍? 4倍是经过证明最好的选择。在1到4倍之间,性能显著上升;大于4倍之后,比如8倍,16倍,性能提升不高,参数量显著增加,计算量显著增长。
-
Transformer 的 FFN 中对每个位置的变换是独立的,那不同位置之间会共享参数吗? 会共享参数。 参数会不断更新吗?既然不断更新,怎么还能共享呢?是每次作用一个token,就计算梯度,然后更新参数,再用更新的参数继续下一个token计算吗?
- 共享参数的时机和参数更新的时机。 共享参数是指,在同一次前向传播,对于序列中的不同token,用的是同一组权重矩阵。而,参数更新是整个batch的前向+反向完成之后,根据所有位置、所有样本的梯度总和,进行一次更新。
-
前馈神经网络的层数有要求吗?放大向量的维度有要求吗?
一般是2层。2层是性能和效率的平衡。通用前馈神经网络是层数是任务具体决定的。
放大的维度是4倍。如果低于4倍,模型可能欠拟合,如果高于4倍,参数量会巨大,但是模型提升的性能很少甚至过拟合。
残差
- 解决的问题:残差能让模型层数和参数大幅增大。
-
如何理解:反向传播时,经过每一层,梯度都要乘以这一层权重矩阵的参数,如果所有权重矩阵的参数都小于1,梯度会减小的非常快;导致浅层参数直接不更新;(这句话的理解,用一个例子手算感受一下,链式法则的时候怎么会乘以权重矩阵的参数,直接用标量)
- 梯度消失/爆炸; 什么是梯度消失/爆炸?
- 网络退化; 增加网络层数导致训练误差上升。 (多重非线性复合之后,恒等映射难以学出来。) 让网络的一部分层去学习残差F(X) = H(X) - X ,H(X) 是目标函数。
-
为什么直接相加就可以?网络如果相差很多层,还能直接相加吗?
- 维度匹配:向量经过自注意力计算再输出,维度不变;学习残差比学习原始映射更容易;
- 残差网络的输出是 x + F(X), F(X)是当前模块学习到的残差函数。反向传播时,求导之后有个常数项1,能保证有一部分梯度可以被利用。
一些问题
-
正余弦位置编码实际能有效区分的最大距离是多少?
- 理论上没有最大值,但实际上,受限于浮点数精度。前半句:对于同一个维度来说,不同的pos对应不同的值,从数学角度上证明,他是一个单射函数。如果想要值相等,pos相差是pai的整数倍,这是一个无理数。所以不可能。。后半句,当维度很大时,周期变得很大,此时即使pos相差很大,值相差也不明显。
-
三种掩码矩阵:padding mask,在decoder训练时,
- padding mask:PAD对应的位置时 负无穷;防止计算注意力时考虑无意义的填充位;
- Causal Mask :上三角为负无穷,下三角为0,表示可见
- Decoder训练时,会把上面2种矩阵逻辑或,生成一个矩阵;
-
Post-Norm 和 Pre-Norm
- 原论文:post-norm:先得到子层输出,加上残差, 再归一化。不好:残差的部分包括了没有归一化的子层输出。可能数字不稳定。
- 更主流的:pre-norm:残差直连路径不受LayerNorm的影响,梯度可以无损传回。
-
如果输入和输出相隔多层,残差还有效果吗?
- 有的。残差连接确保任意相隔层数的输入输出之间,至少有一条恒等梯度路径。当X L变化时,对X0求导,梯度中有一个与层数无关的单位矩阵,梯度不会消失。
-
encoder的层数是不是越多越好?直觉上看,encoder层数越多,是不是能学到更多的细节,获得更丰富的语义表示?
- encoder的层数过多时,各个token的信息过分融合,不同的token的表示会变得越来越像;
- 更深的话,表达能力不一定增强,反而会增加模型复杂度、参数量,让模型学习到噪声;
- 层数越深,反向传播时,会引起梯度爆炸、梯度消失等问题,虽然有残差和层归一化缓解,当还是有一部分的梯度是无法利用的,白白浪费了;
- 了解一下ROPE编码
- 了解一下关于翻译的指标。BLEU,他的改进版mentor,BP,ter, 语义伪对齐,平行语料,长句翻译的mismatch;
究极重要的时间复杂度
- RNN推理时的时间复杂度,以第3步为例,推理时,它需要的计算量就是常数级别的,和序列长度无关。具体就是:输入乘以一个矩阵,加上上一层的记忆乘以一个参数矩阵,相加,可能再加一个偏置,反正跟序列长度无关。
- RNN训练时无法并行,因为所有位置预测的token不能同时得到。不像transformer。
MoE
一句话说明MoE是干嘛的?以transformer为例,token 都走一个 FFN; MoE有许多FFN,不同的token走不同的FFN;
计算量可控,巨大模型参数着增加模型表达能力。
整体流程:MoE 中,路由器根据输入为每个 token 选择最合适的 Top-K 专家,只让这些专家计算,然后加权聚合输出;增加了模型容量(很多专家),又控制了每次计算量(只激活少数专家)。
每个token向量独立选择专家。 在视觉MoE中,整张图片的patch token 走同一个专家组合。
-
核心组件:
- 专家:每一个专家是一个前馈神经网络Feed-Forward Network,通常两个线性层+一个激活层,有自己的参数;
- 路由器:一个线性层,输出每个专家的得分;矩阵大小 [向量维度,专家数]。这是一个可学习的矩阵。
- 根据分数选择top-K专家;
- 聚合:将选中的专家的输出按照分数加权求和。
- 输出:聚合后的向量,作为MoE层的输出;
劣势:专家路由、存储巨大参数、负载均衡、多卡通信;
举一个详尽的例子理解:token 和专家的关系是几对几?一个 token 送给多个专家之后,token 数量会变多吗?
路由器的超参数有哪些?专家数量、top K 的 K;非常重要的专家容量系数:控制每个专家最大能接受多少的 token,为了负载均衡,N 个专家 一共 T 个 token,K 路由。公式是什么?辅助损失函数的系数。λ大小如何如何影响负载均衡。
路由器是线性吗?是纯线性的。因为只做加权打分,足够用,经过前面的注意力层,信息已经足够丰富。
加权这步有没有参数?没有。系数是路由器的打分经过 sofamax。
保证每个专家专精需要多大的训练量?不一定,可以用上面的公式简单看一下有没有达到负载均衡的计算量。
不可导问题:路由器很难从主任务的损失中直接学到哪个专家更适合哪个 token。
这个不可导到底带来的是什么问题?专家不好训练 还是选择哪个专家这一步不好训练?
某个 token 选择了专家一,进行前向计算得到损失,为什么这一次的损失对没选到的专家的参数梯度就是 0?从反向传播的链式法则看,那里的 Y 都不含其他专家的权重怎么能对他们的参数求导呢?更直白:损失函数 L 里面都没有他的参数,怎么求导?
所以说离散导致不可导问题,原因是,因为有一步离散操作,最后主任务的损失函数中没有路由器的权重参数,导致梯度大部分为 0.
如何解决这个问题?转化为让路由器选择专家之后,主任务的损失函数有路由器的参数。路由器不是单单根据打分结果 gate,离散地只留下最好的那个专家(此时损失函数没有任何 gate);而是保留多个gate,加权求和的方式得到路由器的输出计算损失函数。此时损失函数包括 gate,而 gate 又是路由器的权重参数推出来的。
为什么选择专家时,Top2 要比 top1 更好?top1 有什么问题?只选择一个的话,他只会考虑如何调整专家一让损失更小,而关注不到直接选择专家二损失会更小。如何解决这个问题呢? 引入辅助损失函数。引入噪音等等。
MOE为什么要按照token分配专家,而不是整句路由?
一句话内部的token 需求不同。The Python function calculates the matrix inverse. 代词给语言类专家,Python 给代码类专家。 而且 token 已经融合了整句话的信息,MOE用单个 token 选择专家已经考虑了整句话的信息。
需要回答的问题:
-
MoE 会不会让推理速度变快?总参数相同的稠密模型,更快;激活参数相同, 更慢,路由开销、通信开销;
-
MoE 和 Ensemble
-
MoE 在视觉中主要用在哪个位置
在 Vision Transformer (ViT) 中,MoE 通常替换 FFN 层。每个 Transformer block 中的 FFN 被替换成一个 MoE 层(多个专家 FFN + 路由器)
- token-level 还是 image-level?有什么区别?
token-level:每个图像 patch token 独立选择专家。优点是灵活,缺点是计算开销大,且不同 token 可能去不同专家,需要复杂的通信。
image-level:整张图像的所有 token 共享同一个专家选择(根据 class token 或平均特征)。优点是简单高效,适合图像分类。V-MoE 就采用了 image-level 路由
- 专家数量一般设多少?参数增加多少?
16 32 64 个专家;如果有 E 个专家,每个专家是一个 FFN(两个线性层),则 MoE 层的参数量是普通 FFN 的 EE 倍。但因为每次只激活 Top-1 或 Top-2 个专家,计算量只增加 1~2 倍。
- 为什么替换FNN层,不替换Attention层? 每个token计算独立,FFN的参数多。
- 为什么适合大模型? 大模型核心矛盾:更多参数——》模型更强表达能力——》计算量太大; 稀疏激活,总参数量很大,但是计算量不增加。
Prefill
为什么现在大模型都是decoder? 现在大模型的任务是拿到一个问题,给出回答。这和 decoder 的工作:根据已有上下文,逐token 预测下一个 token 是匹配的。
但是因为没有了 encoder,所以 decoder 没有交叉注意力了。
decoder only 的 prefill 和 transformer 的 encoder 有什么区别?前者在生成 KVcache 的时候是 causal attention。后者是双向 attention。
prefill 阶段为啥需要把每一层的 KVcache 都保存下来? 新生成的 token在每一层都要做计算:最新生成的 token 的 Q 和历史所有 KV 做乘法。每一层关注的是不同的信息。
多模态大模型还是需要的。 要把图片,音频这种非文本 token,编码成模型能理解的向量。
LLM 是大语言模型,他的速度包括两方面,prefill 和 decode。
M3 Ultra 的大缓存指的是什么?统一内存是什么意思?还有其他内存吗?512GB M5MAX最高是128 。 大缓存就理解为统一内存很大。 统一内存是相较于传统的不统一。Apple的CPU GPU NPU可以共享一块公共内存。
Prefill 的关键是矩阵运算,所以提速主要是计算架构和矩阵乘法专用单元。
decode的关键是什么?统一内存或者说显存吗?显存决定能不能放得下。影响速度的还是内存、显存带宽。 这里的带宽是指数据从哪到哪呢?占内存的主要是 KVcache 和 模型权重。
Neural Engine是什么? NPU 。 加速神经网络推理。 为什么不直接用GPU?Apple的soc设计—统一内存。优势。 统一内存太强了。
M5 Max 比 M3 Ultra 的 prefill 优势在哪?
-
先明白prefill的核心瓶颈是什么?
-
最显著的是M5 不止有独立的npu,每个GPU核心都有neural accelerater。专为加速矩阵乘法设计的。
-
另外就是 prefill很吃并行能力,可以用到M5新的GPU架构。
为什么M5 的prefill又比不过 5090?
- 主要还是硬件规模差距太大。前者GPU核心数远少于后者CUDA核心数。
MTP :multi token prediction 专为M芯片开发的推理引擎。方法是:原始的自回归解码,每次预测只生成一个token。MTP ,一次猜出N个token,然后拼接前文进行一次验证,把预测正确的保留。
为什么MOE能提升prefill? 因为注意力层后面有前馈神经网络层,对每个token,每次计算不用使用全部参数。 为什么MOE能提升decode?因为每生成一个token需要遍历所有权重参数,现在只需要遍历部分专家。
常见的量化方式: FP8 INT4
知识清单
学习一下lora:Low-Rank Adaptation,低秩适配
硬件相关常识:P核E核的区别?数据交换?英伟达有哪些类别显卡?消费级和什么级别?他们的架构有什么区别?
开始写项目
1准备数据
-
按格式建立数据集和测试集,两个CSV文件。text列和label列
-
分词。把一个句子切成token,然后建立词表。得到词表之后,才能在词表查ID。 因为Transformer的输入是一个向量不是一个字符串。具体实现就是遍历所有句子,用分词方法切出token,统计频次,加特殊符号,给每个token赋予一个唯一的ID,保存成vocab.json
- 统计词频的作用:1为出现频次高的单词分配较小的ID;2过滤罕见的、拼写错误的低频次,不让他们进入词表(防止词表膨胀太多)。
得到词表会做两件事。1把句子转成ID序列;2训练和推理必须用一个vocab;
-
把句子变成模型输入:创建dataset, dataloader。先把CSV里面的句子,查词汇表变成对应的数字序列,再填充对齐到一个输入句子的长度,转为张量。(这里是因为batch训练要求所有句子长度一致)
- Dataset 生成模型可以输入的数据;
-
DataLoader帮助批量打乱、取一个batch的训练数据;
- dataloader里面的一个batch,input_ids是若干个句子,比如他的尺寸是32*20,有32个句子,每个句子长度是20
- Python 类继承的规则:前后双下划线的方法是 魔法方法。在继承父类时,前后有下划线的方法,是父类要求实现的,参数不能改,名字不能改。init是所有类都有,创建对象时自动调用
2写一个小的baseline
用最小模型验证一下,损失是否下降,ACC是否上升
-
写Embedding。Dataloader只是把句子映射成编号,嵌入层负责把编号映射成词向量。dataloader出来的是,一个句子对应的编号,比如:[12, 45, 78, 90,…] 这里的12代表的是“happy”,经过Embedding层,能把happy对应的12 变成一个向量,比如[0.23, 0.56, …]
-
Embedding ----> Mean Pooling ----> Linear;
- 嵌入层的输入形状,batch_size, seq_len; 输出:batch_size, seq_len, embed_dim; Embedding会查表。
- 均值池化做什么:一句话有50个向量,浓缩一下变成1个向量,代表整句话的语义。
- Linear 全连接层,把浓缩好的句子向量,映射成分类概率。
-
代码解释
self.embedding = nn.Embedding( num_embeddings=vocab_size, # 词典多大 embedding_dim=embed_dim, # 每个词变成多长的向量 padding_idx=pad_id # 告诉模型哪个是填充词 ) # 创建词向量查表层,本质是返回一个二维矩阵,得指明这个矩阵有多少行,每一行的词向量的维度是多少? 这张表的数字会在训练过程中不断优化 # 创建之后的使用方式,像函数一样调用它,但它不是函数,是查表;input_ids的形状,也就是embedding输入的形状:[batch_size, seq_len] 是二维的,每一个行向量有seq_len个数字,代表句子的词向量对应的编号; embeddings = self.embedding(input_ids) # 上面代码,查表之后的输出形状:embedding :[batch, seq_len, embed_dim];背地里会把整数变成浮点向量、pad自动变成零向量;这张表的数字会在训练过程中根据损失不断更新 ==================过程到底干了什么========================== for epoch in 范围: for input_ids, labels in dataloader: # 1. 前向传播(查表,拿到词向量) logits = model(input_ids) # ↑ 这里用了 Embedding 表,但【还没更新】 # 2. 算损失 loss = criterion(logits, labels) # 3. 反向传播(计算所有参数要怎么改) optimizer.zero_grad() loss.backward() # ↑ 这里会算出: # - Linear 层怎么调 # - Embedding 表 每一行怎么调 在这里算! # 4. 更新所有参数(真正修改数值) optimizer.step() # ↑ 这里会真正修改: # - Linear 的权重 # - Embedding 表里的每一个值 在这里更新! ====================以上================================== -
model.train() 打开训练模式:Dropout 生效、BatchNorm 用批次统计
model.eval() 关闭训练层:Dropout 不丢神经元、BatchNorm 用全局统计
dropout 训练时随机关掉一部分神经元,防止过拟合;测试时,所有神经元都参与;
BatchNorm 对数据进行标准化,让训练更快更稳。训练时,每个batch用自己的均值方差,测试时,模型已经知道整个测试集的均值和方差,使用测试集的,注意不是训练集的。
注意力机制
1解决模型输入的向量长度不确定
2.一般神经网络,输入一定,那么输出也一定;比如在判断句子中的词性,两个单词长一样,但是词性不一样。所以输出肯定要求不一样,怎么解决这个问题?让fully connect network 考虑得更多,上下文context咨询。把这些向量串起来,一起丢进神经网络。 “把向量串起来” 是有窗口大小限制的,输入的长度不确定,不可能让窗口无限大。 注意力机制就是解决这个问题,能覆盖所有输入之间的关系 。
自注意力机制是输入几个vector就输出几个vector吗;
- 是的。每个新向量都对应之前的那个词,但是新向量的内容变了。而且向量的维度也不变,因为后面有残差连接。
self-attention是怎么做到考虑所有输入向量之间的联系的?输入有4个a向量,输出4个b向量;b1向量是怎么得到的?
- 先计算每两个向量之间的相关性;
- 如何计算两个向量的相关性,每个向量分别乘以预先训练好的矩阵,得到Q,K,V向量,再用当前向量的Q和每一个向量的K点积,得到衡量相关性的注意力得分。再经过Softmax(这些注意力得分有大有小有正有负,转化为加起来等于1的概率分布,对于一个输入向量的第i个元素的概率,分母都一样是所有元素的e指数全部求和,分子是这个元素的e指数),得到概率,再将每一个概率乘以对应向量的V,最终得到输出向量。此时输出向量具有上下文关系。
- Q代表当前词想要提取的信息;K代表这个词能提供什么信息;V代表这个词要被提取的信息;
怎么理解self-attention没有向量之间的位置信息?
- 我爱猫 和 猫爱我 这两种输入在self-attention眼里是完全相同的输入;语序一变整个句子的意思就变了。
- 在什么时候加? 在第一次送入transformer层之前,只加一次。后续层会通过残差连接,位置信息自然保留到到高层。
- 怎么和初始向量结合:直接相加。
- 位置编码方法:正弦余弦位置编码
多头注意力机制:
- 为什么需要? 相关性有很多方面。头1专门学主谓关系、头2专门学因果关系(关注因为所以这些关联词)
- 如何实现:经典参数举例:词向量的维度是512,一共8个头; 最终肯定要得到维度是512的向量。每个头的3个权重矩阵是,512*64 (把权重矩阵的第二个维度分成8份); 然后经过点积、加权求和得到的输出向量的维度是64; 然后把8个向量直接拼起来拼成512维度。再乘以一个专门的大矩阵 512x512,把这 8 份来自不同侧面的信息,线性融合成最终的完整多头注意力输出。送入下一步的前馈神经网络。
缩放
- 在得到注意力得分之后,Softmax之前,需要将每个得分除以根号下输入向量的维度。
- 原因:向量纬度越高,点积的绝对值会变得很大,经过Softmax之后,有一个概率会碾压其他所有概率,并且反响传播时,梯度消失,权重不更新。(存疑)
- Softmax的公式:对于一组输入向量,分子是什么、分母是什么?
self-attention相当于在普通的神经网络结构,加了一个步骤,考虑向量之间的联系对吗?
- 是的。
编码器的结构
-
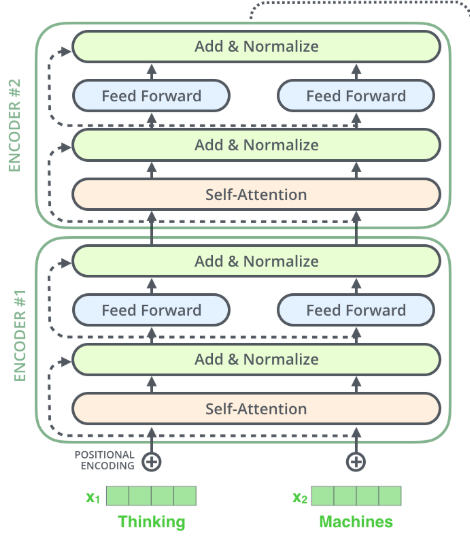
- 输入文本、分词、查嵌入表得到嵌入向量,加上位置编码,向量拼起来送入编码器。 编码器层的输入是上一层的输出。 编码器主要由2个部分,多头自注意力和前馈神经网络。这两部分,每一个后面都有残差连接和层归一化。
- 残差和层归一化出现的时机:每次向量送入自注意力或者前馈神经网络,都会开一条路直接连接到输出向量。
- 残差:直接把输出向量加上这一层原始的输入向量。为了保证能保留原始语义,消除梯度消失。
- 层归一化:为了防止数值漂移。步骤:先计算向量每一个位置的均值和方差,再标准化,然后用两个参数进行缩放和平移。 缩放系数和平移系数是可调参数。 每一个维度的两个系数是不同的。所有向量的同一个维度 归一化参数是相同的。
-
前馈神经网络:一个编码器层只有一个前馈神经网络,各个层之间的前馈神经网络的权重是相互独立的,不共享。
- 作用:进行一次深度非线性加工,提炼更复杂的特征。
- 组层:两个全连接层+激活函数;
- 流程:输入 x → 线性层1 → ReLU激活 → Dropout → 线性层2 → 输出
-
编码器为什么设置层间权重不共享,为什么设置层内权重共享?
- 层间权重不共享包括:注意力权重矩阵(每个头的投影矩阵、最后的拼接投影矩阵)、前馈网络的权重、层归一化的参数。
- 作用:为了让不同层提取不同的特征。底层关注较浅的语法特征,高层关注更抽象的情感信息等等。
- 层内权重共享:可以处理变长序列,减少参数量。
解码器的结构
-
-
输入是什么?训练和推理时,输入不太一样;
- 解码器的第一层掩码自注意力层的输入是什么,起始符号吗?
- 推理时,输入的最开始是一个起始符< sos>,生成第一个词“我”;然后输入更新为 sos 我; 再次跑整个解码器,知道输出结束符eos停止。
- 训练时,输入是目标语言句子(比如要生成的翻译结果)整体右移一位,并且前面加上起始符,由于有掩码,所以看不到当前位置的后面。
-
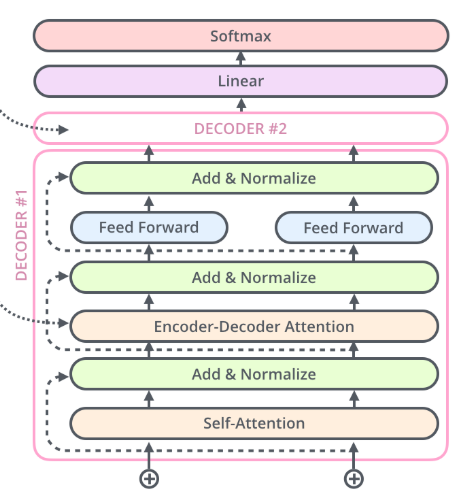
三部分构成:掩码注意力层、交叉注意力层、前馈神经网络层。(每个层后面都有一个残差连接和层归一化)
-
掩码自注意力:
- 为什么需要掩码?训练时防止信息泄漏,预测时防止崩溃、瞎预测。
-
掩码的具体实现:推理和训练时,不太一样。
- 基本思路是:Q和V点积之后得到原始分数矩阵,在进行加权求和之前,把这个矩阵加上一个掩码矩阵,使得,在softmax时候,当前位置对他未来位置的注意力权重都是0。 具体实现:得分矩阵加上一个掩码矩阵,这个矩阵的对角线及其左下角全零,右上角是负无穷,这样做之后,每个位置的未来位置的注意力权重就是0。
- 推理时,解码器是串行生成一个个向量。输入序列也是逐步增长。推理的时候,也看不到没有生成向量的K。所以第一次做点积QV,只有这个向量和第一个位置的K做点积。 但是掩码并不多余,可以防止看到后面的空位。
-
交叉注意力层
Mamba思考:如何在没有注意力矩阵的情况下,实现Transformer中跨注意力层的这种跨序列状态融合。
- Q来自解码器自己,就是上一层掩码自注意力的输出;K和V来自编码器最终的输出。编码器最终的输出被解码器每一层共享,作为字典反复查询。目的是,让解码器回顾源句的意思。
- 具体计算流程:编码器输出的矩阵E(行数是向量的个数,列数词向量的维度数,把向量当作行向量拼起来,记住这个规则) ,解码器上一层输出的矩阵是H。 Q是H乘以权重矩阵生成,K和V是E乘以权重矩阵生成。然后计算注意力分数,加权求和,残差连接,层归一化。
线性层和Softmax层
-
transformer的最终决策层。在总的词汇表中找出得分最高的那个,作为当前输出。
-
具体过程:把解码器输出的矩阵(3个词,就是3个512维的向量),乘以一个权重矩阵512X30000,(词汇表一共30000个词),得到一个新的矩阵,矩阵的每一行就是 这个词向量对应词汇表中每一个词的原始得分。原始得分有正有负,进过Softmax,变成权重,选择权重最大的那个位置对应的词作为输出。
-
具体过程:
-
第1步:生成第1个词 “我”
解码器输入:只有 1 个词,即起始符 [<sos>]。

编码器输入:整句完整的 “I love cats”。

过程:编码器输出 E (3×512),解码器输入 [<sos>] 处理。

解码器输出矩阵:1 × 512 (因为输入只有1个词)。

线性层取哪一行?:取这 仅有的一行(对应 <sos> 位置)。

Softmax结果:预测出下一个词是“我”。
==================================================

第2步:生成第2个词 “爱”
解码器输入:拼上新词,变成 [<sos>, 我],共 2 个词。

编码器输入:依旧是完整的 “I love cats”。

过程:编码器 E 不变(3×512),解码器重新跑一遍整个输入序列。

解码器输出矩阵:2 × 512。

线性层取哪一行?:取 最后一行(即“我”对应的那个输出向量)。

Softmax结果:预测出下一个词是“爱”。

关键:第一行 <sos> 的输出这次我们不关心,我们只关心用最新的词预测下一个词。
==================================================

第3步:生成第3个词 “猫”
解码器输入:[<sos>, 我, 爱],共 3 个词。

解码器输出矩阵:3 × 512。

线性层取哪一行?:取 最后一行(即“爱”对应的那个输出向量)。

Softmax结果:预测出下一个词是“猫”。
==================================================

第4步:生成结束符 <eos>
解码器输入:[<sos>, 我, 爱, 猫],共 4 个词。

解码器输出矩阵:4 × 512。

线性层取哪一行?:取 最后一行(“猫”对应的向量)。

Softmax结果:预测出 <eos>,停止生成。
以上过程可以看出,编码器每次输出的矩阵是逐渐变大的,并且取最后一行送入线性层然后生成最终结果。
transformer的训练和推理
- 训练:完整地输入原句和目标句,生成完整的嵌入向量。训练时完整的目标句整体右移一位加上起始符号,作为解码器输入,用掩码保证每个位置只看到过去。 如何理解:模型并行计算所有位置的预测,一次性算出整体损失。 训练时目标句嵌入是完整的,一次性的。
- 推理:没有完整的目标句,一步步生成。每一步都把已经生成的前缀做嵌入和位置编码,送入解码器。 推理时,目标句嵌入一直在用,不过tgt长度在增长,内容在更新。
transformer用注意力机制提高模型的训练速度。(为什么)
transformer的结构:由一个编码器和解码器构成,编码器由6个编码器组件组成。(编码器组件的个数属于可调参数) 编码器组件的结构相同,都是由一个自注意力层和一个前馈神经网络构成。但是编码器组件之间的权重不同。解码器组件相比编码器组件多了一个注意力层,让解码器能够注意到输入句子的相关部分。
第二个可调参数,是编码器接收的向量长度(向量的维度)。一般来说是训练集中长度最长的句子的长度。
时间复杂度分析
嵌入向量是什么?
-
词经过查嵌入表得到嵌入向量。
-
就是一个词经过嵌入模型生成对应的向量,这个向量具有固定长度。(更强调学习过程)
-
BERT:能把自然语言变成充满上下文信息的向量。本身不做任何应用,但是微调后可以做大量NLP任务。BERT 虽强,但受限于 O(n²) 复杂度,处理很长的文档时必须切成短块,可能丢失跨块信息。 因为BERT底层还是transformer的编码器部分。
Transformer 的前向计算中,流程:
输入文本 → 分词 → 查嵌入表得到嵌入向量 → 加上位置编码 → 送入自注意力层
transformer结构的编码器和解码器是如何配合的?编码器的输出要给解码器的每一个层吗?
- 编码器的输入、输出是什么?输入:源语言经过嵌入和位置编码后的向量序列。输出:同样长度的向量,但是每个向量有上下文关系。
-
编码器首先处理输入序列。生成一组具有上下文关系的向量。
- 生成的向量,又会被投影成一套K和V,作为字典,供解码器使用;解码器生成一个词,就用自己的Q和编码器生成的那些K做点积,得到注意力分数,然后权重(分数soft Max一下)乘以V抽取相关内容。
- 这一部分就是Cross attention,连接encoder和decoder的桥梁。
- 解码器的自注意力加掩码是什么意思?解码器生成时是自回归的什么意思?解码器为啥要生成词?我有点不懂逻辑了。
- 编码器的QVK是怎么生成的?解码器的QVK是怎么生成的?
- 如何理解“解码器每生成一个词时,拿着自己当前的“我想表达什么”(Q),去编码器输出的源句子所有位置上,问“你这儿有什么相关信息?”(K),然后根据匹配度,从编码器输出里提取相应的内容(V),融入解码器。”
- 编码器的同一套最终输出,都会原样的传给解码器的每一层,所以每一层根据自己的跨注意力子层提取出自己需要的内容。
Seq2seq 是一类任务统称,模型架构的统称。transformer是seq2seq现在最强的实现。
编码器 (Encoder)         解码器 (Decoder)
   ↓                        ↓
把输入序列“读懂”,      拿着编码器给的“理解”,
压缩成一套向量表示。     一个接一个地生成输出序列。
Decoder 的每次输出一个向量, 比如机器翻译,数据库有2000个汉字,那就生成一个长度2000的向量,每个汉字对应一个位置有一个打分,然后取最大的那个分数。
decoder的注意力层是 masked self-attention,每次产生新的向量时,只能利用之前已经产生过的向量。
decoder是一个接着一个生成的,还要能够判断何时停止生成。所以整个数据表除了汉字,还需要有一个结束符号。
我理解的计算自注意力的机制
首先源文本,先经过切分成为一个个词,词查嵌入表得到嵌入向量,此时的嵌入向量是没有上下文关系的,然后把这一系列向量送入自注意力层。首先, 每个向量都经过权重矩阵,W Q W K W V生成对应的Q,K,V。一个向量的Q和其他所有向量的K做点积,得到N个得分,再soft Max一下,然后权重对所有的V进行加权求和,得到新的向量表示,这个新的向量表示就具有了这一段文本的全局信息。