笔记
Qwen3系列2-模型架构和真实推理
Qwen3 系列的第二篇文章。
用代码实现一次真实的前向推理,知道了很多细节。给模型的输入还会被加上标识角色的字段;对于词表的理解加深了,真实词表不是 Token 对应 id,还有隐藏的转化;Decode 阶段 KV 的维度一直在增加。对 Prefill 和 Decode 两阶段掌握更深。
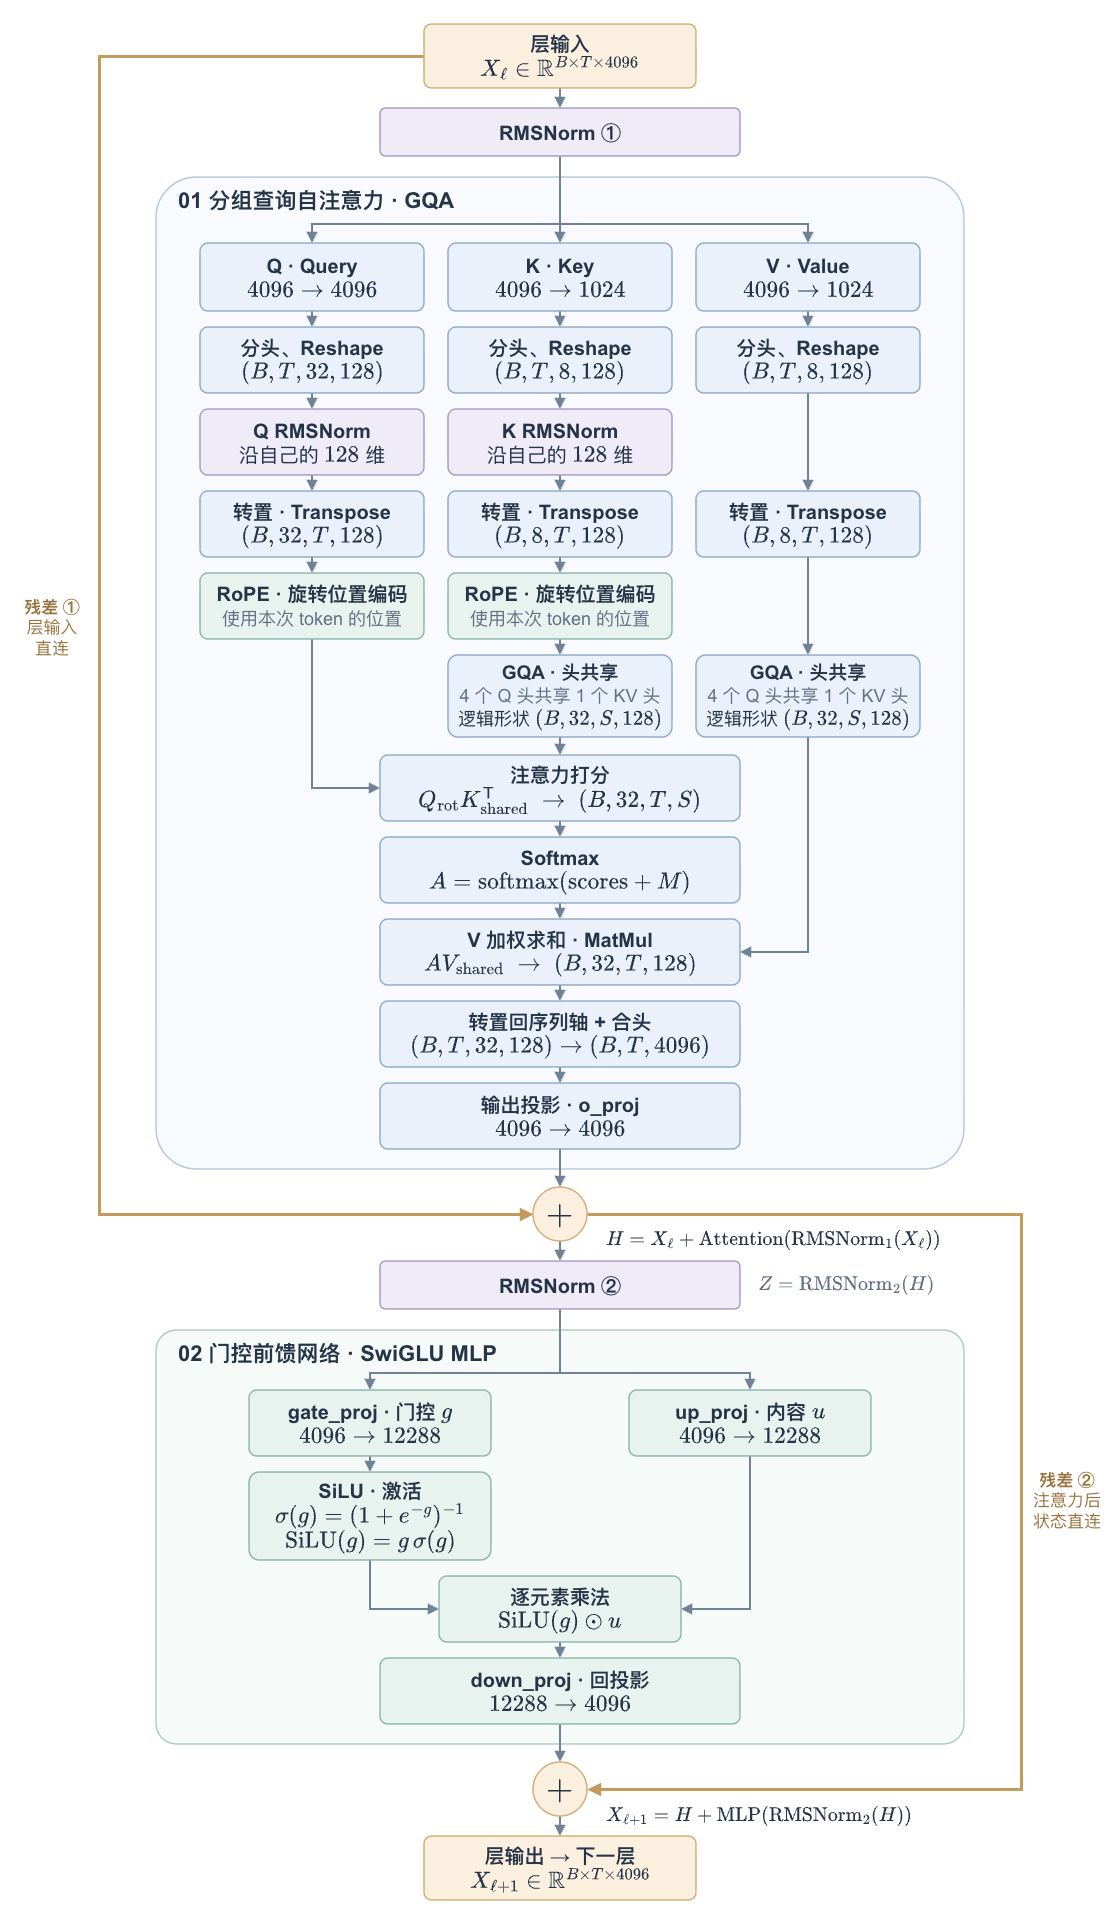
Qwen3 架构有很多容易忘的地方:QK 分头之后还有 Norm;RoPE 位置编码加在哪里?MLP 层的结构;
Qwen3-8B Block 架构图
-
容易忽略的几点: 先 RMS Norm,QK 投影之后还有 RMS Norm;(root mean 均方根)
RoPE 编码的位置:Norm 之后,Attention 之前;
还有个输出投影 Wo;
FFN 之前有 RMS;
FFN 也有 残差连接;
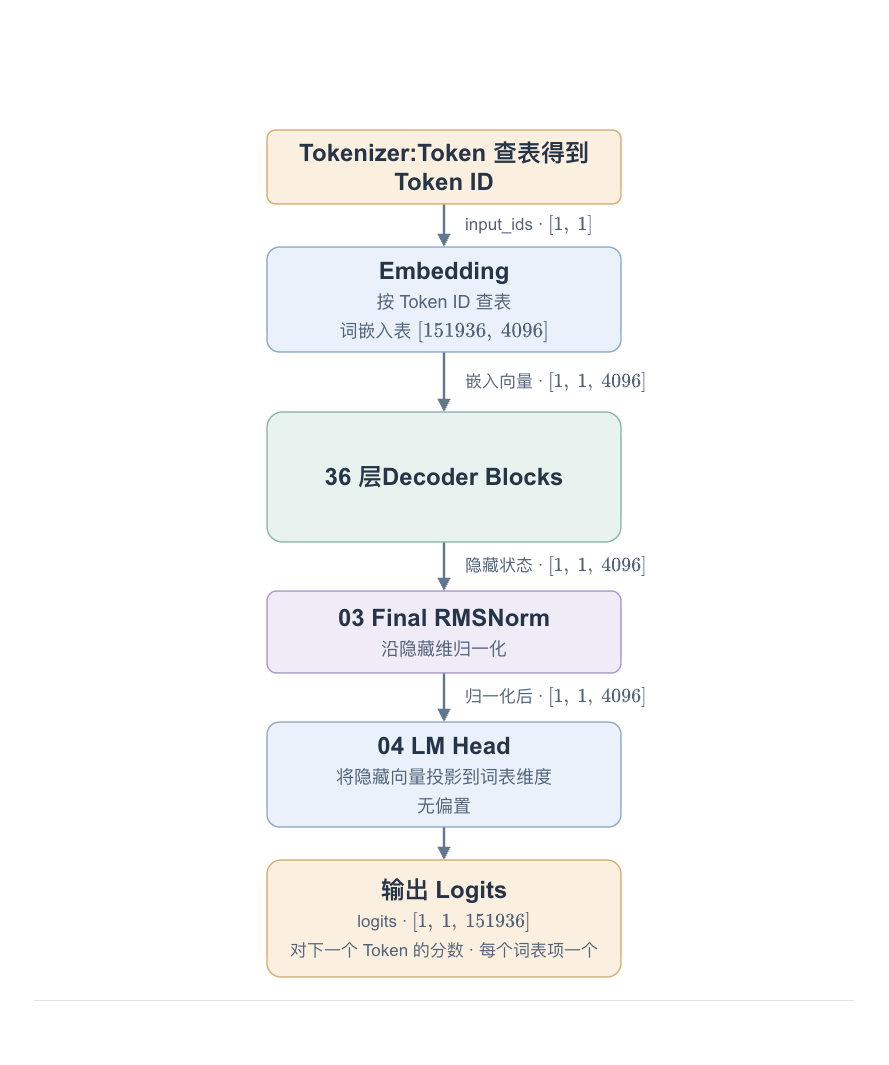
Qwn3-8B 整体结构图
-
文本的输入:
一段长文本 经过 Tokenizer (分词),变成一个个 Token;
每个 Token 查词表 得到对应的 Tokenid;
每个 id 经过 embedding 得到向量;
-
词表也是别人训练好的,模型训练时候是不动的;
embedding 表随着模型训练会更新;
模型最终输出的是一个和词表维度相同的向量;得分最好的 Token 是预测的下一个 token;
一次真实前向推理
输入原始文本,经过分词、查词表得到 Tokenid。
-
原始文本要加 “role”: “user”, “content” ,让模型知道这是用户输入的。这和模型训练时保持一致;
role:user 会被变成特殊 Token:
< |im_start| >user\n模型知道这后面的内容是用户说的;想要模型回答问题:
prompt = tokenizer.apply_chat_template(messages, add_generation_prompt=True, **template)必须给原始信息加入生成提示:add_generation_prompt=True。不然只把原始信息发给模型,模型不会生成回答。注意两个信息的区别:
add_generation_prompt=True之后,文本多了:|im_start| >assistant\n模型看到这个Token,才会开始生成答案;(训练的时候决定的);还多出来的 think 是 Qwen的思考块,表示跳过思考模式;
-
原始信息最后变成了 19 个 Token;[1,19]说明这一轮只有 1 个对话;
-
分词器符号是什么?怎么跟乱码一样?
经常说Token 查词表得到 id。词表是 Token 和 id 的映射,词表里面 Token 的真实样子就是 分词器符号。
分词的时候先把文本转成 UTF8 字节序列,再合并什么的,得到一个 Token。知道这一点也就知道一个 Token 不一定对应一个中文汉字了。
-
messages = [{"role": "user", "content": "请用一句话解释注意力机制。"}]
# 不输出Token_id  输出字符串;关闭 Qwen 思考模式;
template = dict(tokenize=False, enable_thinking=False)
plain_prompt = tokenizer.apply_chat_template(messages, add_generation_prompt=False, **template)
prompt = tokenizer.apply_chat_template(messages, add_generation_prompt=True, **template)

# 把Token查词表变成 Tokenid
inputs = tokenizer(prompt, return_tensors="pt", add_special_tokens=False).to(device)
ids = inputs["input_ids"][0].tolist()
S = len(ids)

print("原始对话", messages)
print("不加生成提示", repr(plain_prompt))
print("加入生成提示", repr(prompt))
print("input_ids.shape", tuple(inputs["input_ids"].shape))
print("位置 | Token ID | 分词器符号 | 解码文本")
for position, (token_id, piece) in enumerate(zip(ids, tokenizer.convert_ids_to_tokens(ids))):
    print(f"{position:2d} | {token_id:6d} | {piece!r:26} | {tokenizer.decode([token_id])!r}")
输出:
原始对话 [{'role': 'user', 'content': '请用一句话解释注意力机制。'}]
不加生成提示 '<|im_start|>user\n请用一句话解释注意力机制。<|im_end|>\n'
加入生成提示 '<|im_start|>user\n请用一句话解释注意力机制。<|im_end|>\n<|im_start|>assistant\n<think>\n\n</think>\n\n'
input_ids.shape (1, 19)
位置 | Token ID | 分词器符号 | 解码文本
 0 | 151644 | '<|im_start|>'             | '<|im_start|>'
 1 |    872 | 'user'                     | 'user'
 2 |    198 | 'Ċ'                        | '\n'
 3 |  14880 | '请'                      | '请'
 4 |  11622 | 'çĶ¨'                      | '用'
 5 | 105321 | 'ä¸Ģåı¥è¯Ŀ'                | '一句话'
 6 | 104136 | '解éĩĬ'                   | '解释'
 7 | 108260 | '注æĦıåĬĽ'                | '注意力'
 8 | 100674 | 'æľºåĪ¶'                   | '机制'
 9 |   1773 | 'ãĢĤ'                      | '。'
10 | 151645 | '<|im_end|>'               | '<|im_end|>'
11 |    198 | 'Ċ'                        | '\n'
12 | 151644 | '<|im_start|>'             | '<|im_start|>'
13 |  77091 | 'assistant'                | 'assistant'
14 |    198 | 'Ċ'                        | '\n'
15 | 151667 | '<think>'                  | '<think>'
16 |    271 | 'ĊĊ'                       | '\n\n'
17 | 151668 | '</think>'                 | '</think>'
18 |    271 | 'ĊĊ'                       | '\n\n'
Token-id 经过 embedding 得到向量
-
Embedding (1, 19, 4096) 三个维度什么意思?
-
L2 范数什么意思? 计算向量的欧氏距离(长度);快速检查有没有异常向量,比如0.1~10 比较合理。如果极大或者极小,说明 embedding 有问题。
-
with torch.inference_mode():
    embeddings = model.get_input_embeddings()(inputs["input_ids"]) # 拿到模型第一层,就是 embedding 矩阵

print("Embedding", tuple(embeddings.shape))
for pos in (0, next(i for i, token_id in enumerate(ids) if token_id != ids[0])):
    vector = embeddings[0, pos].float()
    print(f"位置 {pos:2d} | ID {ids[pos]:6d} | 前 6 维 {vector[:6].tolist()} | L2 {vector.norm().item():.4f}")
输出:
Embedding (1, 19, 4096)
位置  0 | ID 151644 | 前 6 维 [0.01025390625, 0.009765625, -0.01348876953125, -0.007598876953125, -0.000957489013671875, -0.0223388671875] | L2 0.5728
位置  1 | ID    872 | 前 6 维 [-0.01409912109375, -0.0220947265625, 0.043701171875, -0.0004367828369140625, 0.00537109375, 0.0128173828125] | L2 1.7635
一次 Prefill 把所有 Token 都进行前向传播
-
看每个隐藏层的输出形状,每个向量的前三维度;
-
末位置 RMSNorm 什么意思:这个包含 19 个 Token 的序列,最后一个 Token,在进入当前子层的时候进行 RMS;
-
为什么只打印末位置:Prefill 阶段,我们预测的 Token 是根据最后一个 Token 的预测值拿到的;
-
装上 hook:hook 的用法
-
block = model.model.layers[0] # 第0个transformer block
# 每一层有7个投影矩阵,拿到他们;
projections = {
    "Q": block.self_attn.q_proj, "K": block.self_attn.k_proj, "V": block.self_attn.v_proj,
    "Attention o_proj": block.self_attn.o_proj,
    "MLP gate_proj": block.mlp.gate_proj, "MLP up_proj": block.mlp.up_proj,
    "MLP down_proj": block.mlp.down_proj,
}
observed = {}

def record_projection(name):
    def hook(module, args, output):
        observed[name] = (tuple(output.shape), output[0, -1, :3].float().tolist())
    return hook

handles = [layer.register_forward_hook(record_projection(name)) for name, layer in projections.items()]
try:
    with torch.inference_mode():
        prefill = model(**inputs, use_cache=True, output_hidden_states=True,
                        output_attentions=False, logits_to_keep=0, return_dict=True)
finally:
    for handle in handles:
        handle.remove()

states = prefill.hidden_states
print(f"Hidden states 共 {len(states)} 项 | 第 0 项与 Embedding 相同:{torch.equal(states[0], embeddings)}")
print("序号 | 来源                      | 形状            | 末位置 RMS | 前三个分量")
for i, state in enumerate(states):
    if i == 0:
        label = "Embedding"
    elif i == cfg.num_hidden_layers:
        label = f"Block {i - 1} 后做末尾 RMSNorm"
    else:
        label = f"Block {i - 1} 输出"
    vector = state[0, -1].float()
    rms = vector.square().mean().sqrt().item()
    values = ", ".join(f"{value:+.4f}" for value in vector[:3].tolist())
    print(f"{i:4d} | {label:25} | {str(tuple(state.shape)):15} | {rms:10.4f} | {values}")
输出:
Hidden states 共 37 项 | 第 0 项与 Embedding 相同:True
序号 | 来源                      | 形状            | 末位置 RMS | 前三个分量
   0 | Embedding                 | (1, 19, 4096)   |     0.0255 | +0.0269, +0.0096, -0.0079
   1 | Block 0 输出                | (1, 19, 4096)   |     0.1564 | +0.0040, -0.1011, +0.0498
   2 | Block 1 输出                | (1, 19, 4096)   |     0.2008 | -0.0356, -0.1514, +0.0187
   3 | Block 2 输出                | (1, 19, 4096)   |     0.2394 | +0.0771, -0.2812, +0.1602
   4 | Block 3 输出                | (1, 19, 4096)   |     0.2816 | -0.0312, -0.2988, +0.1270

  35 | Block 34 输出               | (1, 19, 4096)   |    24.7146 | -4.7500, +3.3594, -12.1250
  36 | Block 35 后做末尾 RMSNorm     | (1, 19, 4096)   |     2.6914 | -0.0253, +0.4414, -1.6562
打印第 0 个 block 的投影矩阵的维度
-
激活是 hook 抓取到的;
-
能根据 KV 的输出维度,判断出几个 Q 头共享一个 KV ;
-
for name in projections:
    layer = projections[name]
    w = layer.weight                      # (out_features, in_features)
    out_f, in_f = w.shape
    act_shape, sample = observed[name]    # (batch, seq, out_features)
    values = ", ".join(f"{v:+.4f}" for v in sample)
    print(
        f"{name:18} | weight {str(tuple(w.shape)):16} | {in_f:5d} -> {out_f:5d} "
        f"| 激活 {str(act_shape):16} | 末位置前3维 {values}"
    )
输出:
- weight 的形状(out, in);
Q                  | weight (4096, 4096)     |  4096 ->  4096 | 激活 (1, 19, 4096)    | 末位置前3维 -0.0086, +0.0145, +0.0049
K                  | weight (1024, 4096)     |  4096 ->  1024 | 激活 (1, 19, 1024)    | 末位置前3维 -0.2852, +0.0264, +0.2197
V                  | weight (1024, 4096)     |  4096 ->  1024 | 激活 (1, 19, 1024)    | 末位置前3维 -0.0005, +0.0024, -0.0123
Attention o_proj   | weight (4096, 4096)     |  4096 ->  4096 | 激活 (1, 19, 4096)    | 末位置前3维 -0.0236, -0.0554, +0.0206
MLP gate_proj      | weight (12288, 4096)    |  4096 -> 12288 | 激活 (1, 19, 12288)   | 末位置前3维 +0.0044, -0.0260, -0.1504
MLP up_proj        | weight (12288, 4096)    |  4096 -> 12288 | 激活 (1, 19, 12288)   | 末位置前3维 +0.1226, +0.0781, -0.0208
MLP down_proj      | weight (4096, 12288)    | 12288 ->  4096 | 激活 (1, 19, 4096)    | 末位置前3维 +0.0007, -0.0552, +0.0371
经过 LMHead ,得到下一个位置的预测 Token
每一个位置的 Token,映射为 151936 维度的词表大小,每个维度表示原始得分;对得分进行 Softmax,得到最终得分;然后查词表,得到预测的 Token; 预测 下一个 Token 只取最后一个位置的 Token 映射得到的评分表
-
经过 LMHead 投影,再 Softmax,再查表得到预测 Token(像前面说的查表其实得不到真实的 Token,隐藏的有转化)。
-
logits是 softmax 之前的打分向量;softmax 之后叫做概率;
-
第 i 个位置的 logits 是预测哪个位置的 Token?
-
这个例子可以看到最开始我们输入的信息,预测的下一个 Token 是“注意力”;也应证了一个 Token 不是对应一个中文汉字;甚至一个 Token 可能是半个中文字;
-
last_logits = prefill.logits[0, -1, :].float()
print("最终隐藏状态", tuple(states[-1].shape))
print("LM Head 权重", tuple(model.get_output_embeddings().weight.shape))
print("Prefill Logits", tuple(prefill.logits.shape), "| 末位置", tuple(last_logits.shape))
print("最大 3 个分数", last_logits.topk(3).values.tolist())
print("最小 3 个分数", last_logits.topk(3, largest=False).values.tolist())

probs = last_logits.softmax(dim=-1)
top_probs, top_ids = probs.topk(5)
for rank, (token_id, prob) in enumerate(zip(top_ids.tolist(), top_probs.tolist()), start=1):
    print(f"{rank} | ID {token_id:6d} | {tokenizer.decode([token_id])!r:15} | p={prob:.8g}")

next_id = last_logits.argmax().item()
next_input = torch.tensor([[next_id]], device=device)
print("首个生成 Token", next_id, repr(tokenizer.decode([next_id])))
输出:
最终隐藏状态 (1, 19, 4096)
LM Head 权重 (151936, 4096)
Prefill Logits (1, 19, 151936) | 末位置 (151936,)
最大 3 个分数 [51.25, 37.5, 33.5]
最小 3 个分数 [-18.5, -18.125, -17.875]
1 | ID 108260 | '注意力'           | p=0.99999893
2 | ID  60533 | '注意'            | p=1.0677029e-06
3 | ID  97161 | ' 注意'           | p=1.955566e-08
4 | ID 108043 | '注意事项'          | p=7.5825518e-10
5 | ID   6529 | ' attention'    | p=6.691579e-10
首个生成 Token 108260 '注意力'
Decode 送入模型一个新的 Token,复用 KV Cache,观察 KVCache 长度变化,并且得到下一个输出
-
注意:K V 的矩阵维度变化了;Decode 阶段 K V 的维度一直在增长;行数加一;
-
Decode 阶段每次只送入一个 Token;Prefill 是把整个提示词全部送入;
-
生成的下一个 Token 是 “机制”
-
cache = prefill.past_key_values
old_length = int(cache.get_seq_length())
if old_length != S:
    raise RuntimeError("这个 Cache 已用于 Decode,请重跑第 3 步后再运行本格。")
before = [tuple(t.shape) for t in cache[0]]
mask = inputs["attention_mask"]
decode_mask = torch.cat([mask, torch.ones_like(mask[:, :1])], dim=1)
with torch.inference_mode():
    decode = model(
        input_ids=next_input, attention_mask=decode_mask, past_key_values=cache,
        use_cache=True, logits_to_keep=0, return_dict=True,
    )

after = [tuple(t.shape) for t in decode.past_key_values[0]]
second_id = decode.logits[0, -1].argmax().item()
print("阶段     输入形状          Logits 形状")
print(f"Prefill  {str(tuple(inputs['input_ids'].shape)):16} {tuple(prefill.logits.shape)}")
print(f"Decode   {str(tuple(next_input.shape)):16} {tuple(decode.logits.shape)}")
print(f"Cache 长度 {old_length} → {int(decode.past_key_values.get_seq_length())}")
print(f"第 0 层 K {before[0]} → {after[0]}")
print(f"第 0 层 V {before[1]} → {after[1]}")
print("第二个生成 Token", second_id, repr(tokenizer.decode([second_id])))
print("拼起来", repr(tokenizer.decode([next_id, second_id])))
输出:
阶段     输入形状          Logits 形状
Prefill  (1, 19)          (1, 19, 151936)
Decode   (1, 1)           (1, 1, 151936)
Cache 长度 19 → 20
第 0 层 K (1, 8, 19, 128) → (1, 8, 20, 128)
第 0 层 V (1, 8, 19, 128) → (1, 8, 20, 128)
第二个生成 Token 100674 '机制'
拼起来 '注意力机制'
手动 generate() 核验
greedy = GenerationConfig(
    max_new_tokens=1, do_sample=False, use_cache=True,
    pad_token_id=tokenizer.pad_token_id, eos_token_id=model.generation_config.eos_token_id,
)
with torch.inference_mode():
    generated = model.generate(**inputs, generation_config=greedy, use_model_defaults=False)

generated_id = generated[0, S].item()
print("手动 argmax", next_id, repr(tokenizer.decode([next_id])))
print("generate() ", generated_id, repr(tokenizer.decode([generated_id])))
assert next_id == generated_id, "首个 Token ID 不一致,请检查输入和生成配置。"
print("核对通过")
输出:
手动 argmax 108260 '注意力'
generate()  108260 '注意力'
核对通过